תקציר מהיר: משרד ביתי ללא נייר עם Paperless-ngx ופענוח OCR
- סריקה אוטומטית (Auto-Ingestion): פשוט זורקים קובץ PDF או סריקה לתיקיית "consume" או שולחים במייל, והמערכת מאנדקסת אותו עצמאית.
- מנוע OCR מובנה כולל עברית: פענוח טקסט מלא (Tesseract OCR) בעברית ובאנגלית, המאפשר חיפוש מילים מתוך מסמכים סרוקים ותמונות.
- תיוג חכם מבוסס בינה מלאכותית: המערכת לומדת עם הזמן ומנחשת אוטומטית מי השולח (חברת חשמל, ארנונה, בנק), מה סוג המסמך ומה התאריך שלו.
- שליפה מהירה בשניות: מציאת חשבונית או תעודת אחריות של מוצר שקניתם לפני שלוש שנים בחיפוש מהיר של שנייה אחת.
כולנו מכירים את ערימות הניירת שמצטברות במגירות ובקלסרים: חשבונות חשמל ומים, מכתבי בנקים, פוליסות ביטוח, תעודות אחריות למכשירי חשמל וחשבוניות מס. כאשר אנחנו באמת צריכים מסמך מסוים – איתורו הופך למסע חיפושים מייאש ומבזבז זמן.
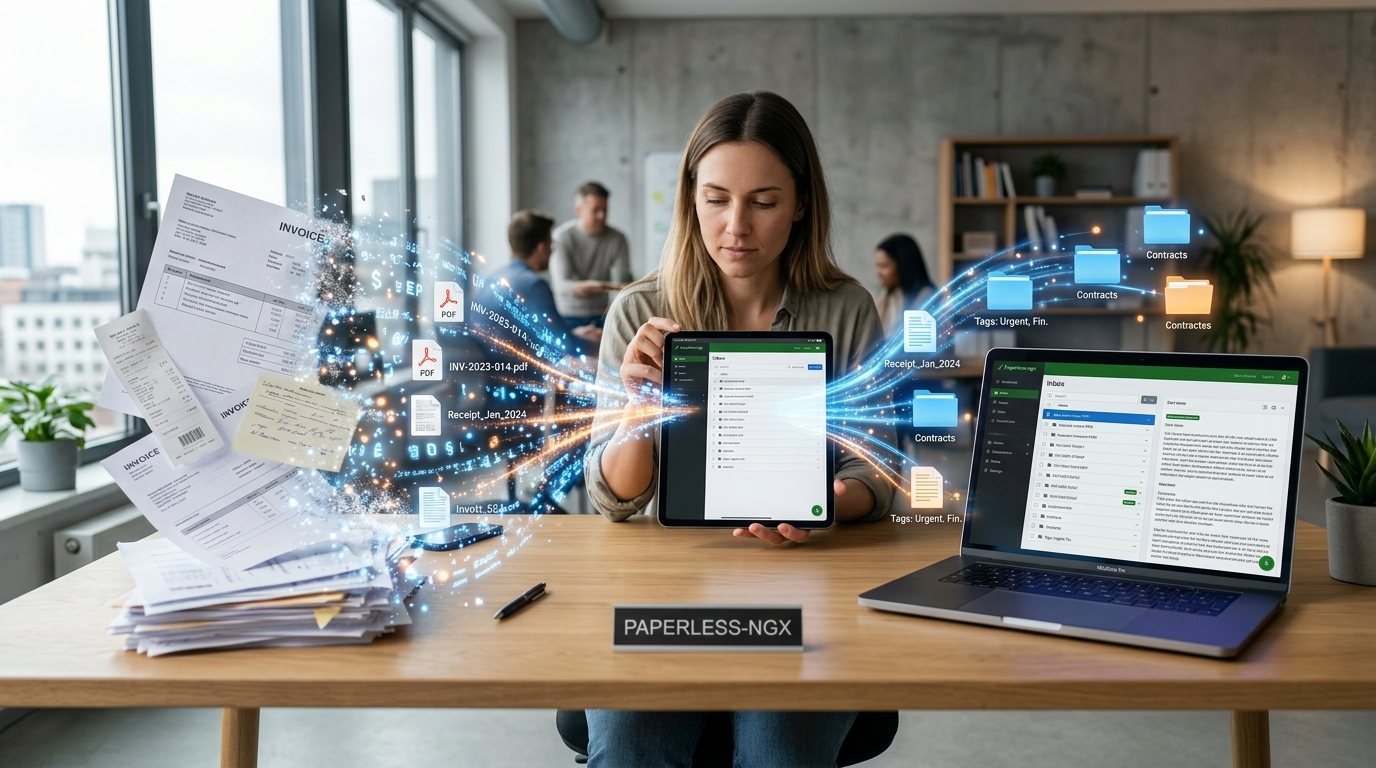
Paperless-ngx היא אחת המערכות המהפכניות ביותר לניהול משרד ביתי וארגוני בקוד פתוח (DMS – Document Management System). המערכת הופכת כל סריקה פיזית לקובץ דיגיטלי חי, מבצעת פענוח טקסט (OCR) מלא, ומאפשרת לכם למצוא כל שורה בכל מסמך במהירות שבה אתם מחפשים בגוגל.
1. איך עובד תהליך העבודה (Workflow) של Paperless-ngx?
- קליטת המסמך (Ingestion): מצלמים מסמך עם הסמארטפון (באפליקציה כמו Paperless Mobile או Genius Scan), סורקים במכשיר סורק משולב, או מפילים קובץ PDF לתיקייה ייעודית במחשב.
- פענוח OCR: מנוע ה-OCR סורק את הדפים ומזהה את כל האותיות והמילים, כולל עברית מלאה.
- סיווג ולמידת מכונה: המערכת קוראת את המסמך ומזהה אוטומטית שמות מוכרים (כמו שמות של רשויות מקומיות, חברות ביטוח ונותני שירות) ומתייגת אותו.
- ארכוב מאובטח: המסמך המקורי נשמר ללא שינוי, לצד גרסת PDF עם שכבת טקסט מוטמעת (Searchable PDF).
2. דרישות מערכת והתקנה באמצעות Docker Compose
Paperless-ngx מורכבת משרת אינטרנט, תור עבודה מבוסס Redis, בסיס נתונים PostgreSQL, ומנוע Tesseract לעיבוד שפה. הדרך הקלה והיציבה ביותר להתקינה היא בעזרת סקריפט ההתקנה הרשמי או קובץ Compose מותאם.
להרצת סקריפט ההתקנה האינטראקטיבי הרשמי, הריצו בטרמינל הלינוקס שלכם:
bash -c "$(curl -fsSL https://raw.githubusercontent.com/paperless-ngx/paperless-ngx/main/install-script/install-script.sh)"
במהלך ההתקנה תישאלו אילו שפות OCR להתקין. חשוב מאוד לבחור בעברית (heb) ובאנגלית (eng)!
אם אתם מעדיפים הגדרה ידנית בקובץ docker-compose.yml, ודאו שמשתנה הסביבה לשפות מוגדר כך:
      - PAPERLESS_OCR_LANGUAGE=heb+eng
      - PAPERLESS_OCR_LANGUAGES=heb
      - PAPERLESS_TIME_ZONE=Asia/Jerusalem
3. התחברות ראשונית וניהול משתמשים
אם לא הגדרתם משתמש במהלך ההתקנה, תוכלו ליצור משתמש מנהל (Superuser) בכל רגע בפקודה פשוטה:
docker compose exec webserver python3 manage.py createsuperuser
כעת פתחו את הדפדפן בכתובת http://YOUR-SERVER-IP:8000 והתחברו לממשק הניהול של Paperless-ngx.
4. ארגון מסמכים: תגיות, שולחים וסוגי מסמכים
כדי שהחיפוש יהיה אפקטיבי, המערכת מאפשרת הגדרת ארבעה מאפיינים מרכזיים לכל מסמך:
- נמענים / שולחים (Correspondents): למשל: "בנק לאומי", "חברת חשמל", "מכבי שירותי בריאות", "אמזון".
- סוגי מסמכים (Document Types): למשל: "חשבונית מס", "קבלה", "סיכום רפואי", "תעודת אחריות", "חוזה".
- תגיות (Tags): תגיות נושאיות כמו "רכב", "דירה", "מיסים 2026", או "דחוף לטיפול".
- שדות מותאמים אישית (Custom Fields): ניתן להגדיר שדות כמו "סכום לתשלום" או "תאריך פקיעת אחריות".